01
757.491/Monat
All-in-One-AppSec-Plattform, die Schwachstellen findet und automatisch behebt
KI-Code-ReviewRedaktionswert: 4.4Freemium+9,6 %

757.491/Monat+9,6 %
All-in-One-AppSec-Plattform, die Schwachstellen findet und automatisch behebt
Freemium
KI-generierten Code vor dem Release auf Halluzinationen, Sicherheitslücken und Bugs prüfen
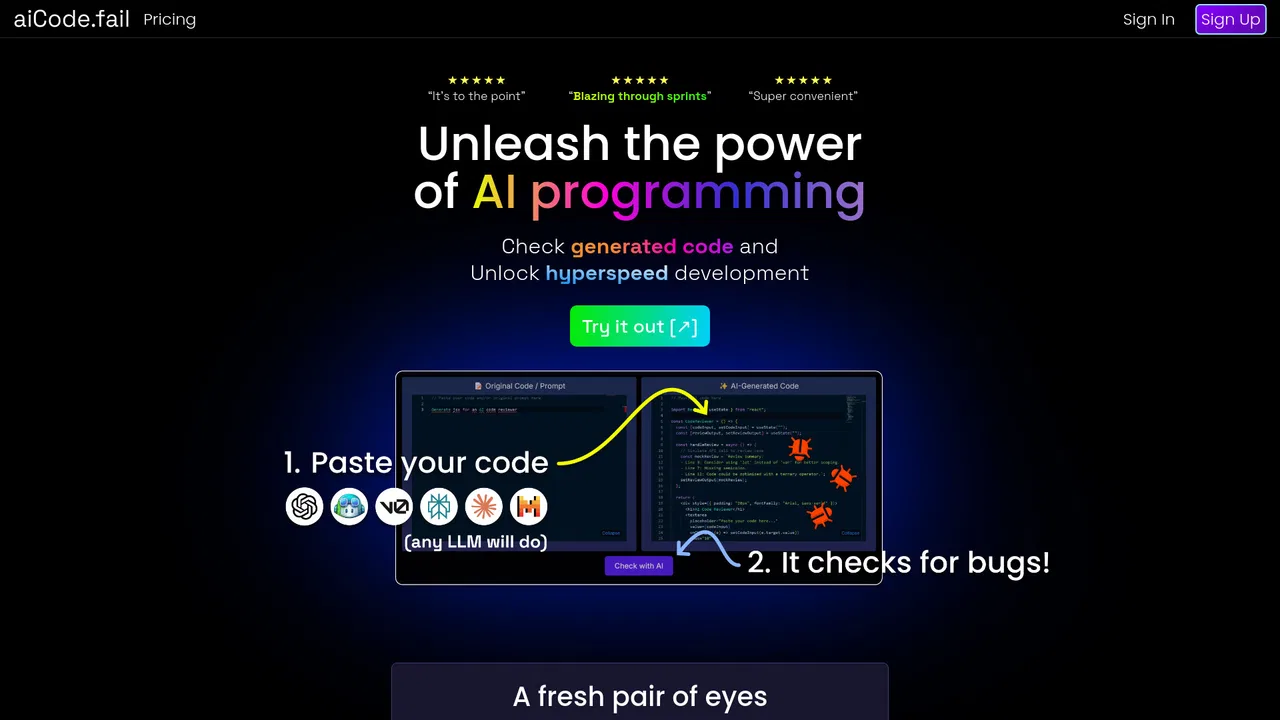
Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist aiCode.fail (aicode.fail) eine KI-Plattform, die unter KI-Prüftool indexiert ist und 0 monatliche Besuche mit einem Traffic-Delta von +0 (0 %) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Global (— Traffic-Anteil) und sie arbeitet mit einem Preismodell „Kostenlose Testversion, Kostenpflichtig“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören Aikido Security (757.491 Besuche/Monat), Command Code (2,36 Mio. Besuche/Monat), EarlyAI (4563 Besuche/Monat).
Hat sofort die erfundenen APIs im GPT-Code gefunden.
Einfach top.
Web-Oberfläche ist nett, aber CLI wäre besser.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
Ein dediziertes Modell prüft generierten Code außerhalb des ursprünglichen Chat-Kontexts, wo Assistenten eigene Fehler selten erkennen.
Audits markieren sicherheitsrelevante Muster wie unsicheren Umgang mit Eingaben, Secrets oder Abhängigkeiten.
Befunde zeigen verdächtige Logik und wahrscheinliche Fehler, damit du Probleme behebst, bevor sie sich in späteren Commits häufen.
Der Prüfer ist modellagnostisch, sodass Ausgaben jedes KI-Assistenten oder Coding-Agenten im selben Arbeitsbereich auditiert werden können.
Du arbeitest in einem vertrauten Monaco-Editor, und dein Code wird nie kompiliert, was das Audit leicht und schnell hält.
aiCode.fail widmet sich einem sehr vertrauten Fehlerbild: KI-Coding-Assistenten erzeugen selbstsicher Code, der subtil nicht funktioniert. Da das Modell, das ein Snippet geschrieben hat, eigene Fehler gern übersieht, wählt das Tool bewusst einen anderen Ansatz. Es analysiert deinen Code außerhalb des ursprünglichen Chat-Kontexts, was eine frische Perspektive schafft und die Chance erhöht, Widersprüche, erfundene APIs oder unsichere Muster zu entdecken.
Im Mittelpunkt des Workflows steht ein Monaco-Editor im Browser. Du fügst den generierten Code ein, forderst ein Audit an und prüfst die Ergebnisse, die in drei Themen gruppiert sind: Halluzinationserkennung, Sicherheitsoffenlegung und Debugging-Unterstützung. Der Dienst gibt an, mit jeder Programmiersprache zu funktionieren, mit allen gängigen LLMs kompatibel zu sein und deinen Code nie zu kompilieren – die Analyse ist statisch, es muss also nichts gebaut oder ausgeführt werden, bevor du Feedback erhältst. Damit eignet er sich als schneller Kontrollpunkt zwischen Codegenerierung und Commit.
Die Preisgestaltung ist unkompliziert. Eine kostenlose Stufe erlaubt Tests mit begrenzten Audits. Bezahlpläne heben diese Grenze auf: Der Jahresplan wird mit rund 5 $ pro Monat und 40 % Ersparnis gegenüber der monatlichen Zahlung angegeben, der Monatsplan mit rund 9 $ pro Monat, beide inklusive 14-tägiger Testphase und sofortigem Kopieren der Ergebnisse. Das Produkt ist auf Product Hunt vertreten und richtet sich an Entwickler, die sich in Sprints auf KI-Assistenten verlassen.
Führe ein schnelles Audit eines gerade erzeugten Snippets durch, bevor du es committest und darauf aufbaust.
Füge unbekannten generierten Code ein, um erfundene Funktionen, unsichere Muster und Logikfehler bei der Prüfung von Änderungen zu finden.
Auditiere vom Assistenten vorgeschlagene Integrationsbeispiele, um fehlende Validierung oder unsichere Standardwerte vor der Produktion zu finden.
Integriere ein automatisches KI-Code-Audit in deinen Workflow, um den Zeitaufwand für vermeidbare Fehler in Sprints zu senken.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | aiCode.fail | 0 | 0 % | — | Kostenlose Testversion, Kostenpflichtig | Aktuell |
| 1 | Aikido Security | 757.491 | +9,6 % | 40% direkt | Freemium | vs Aikido Security |
| 2 | Command Code | 2,36 Mio. | -12,1 % | 74% direkt | Freemium, Preise auf Anfrage | vs Command Code |
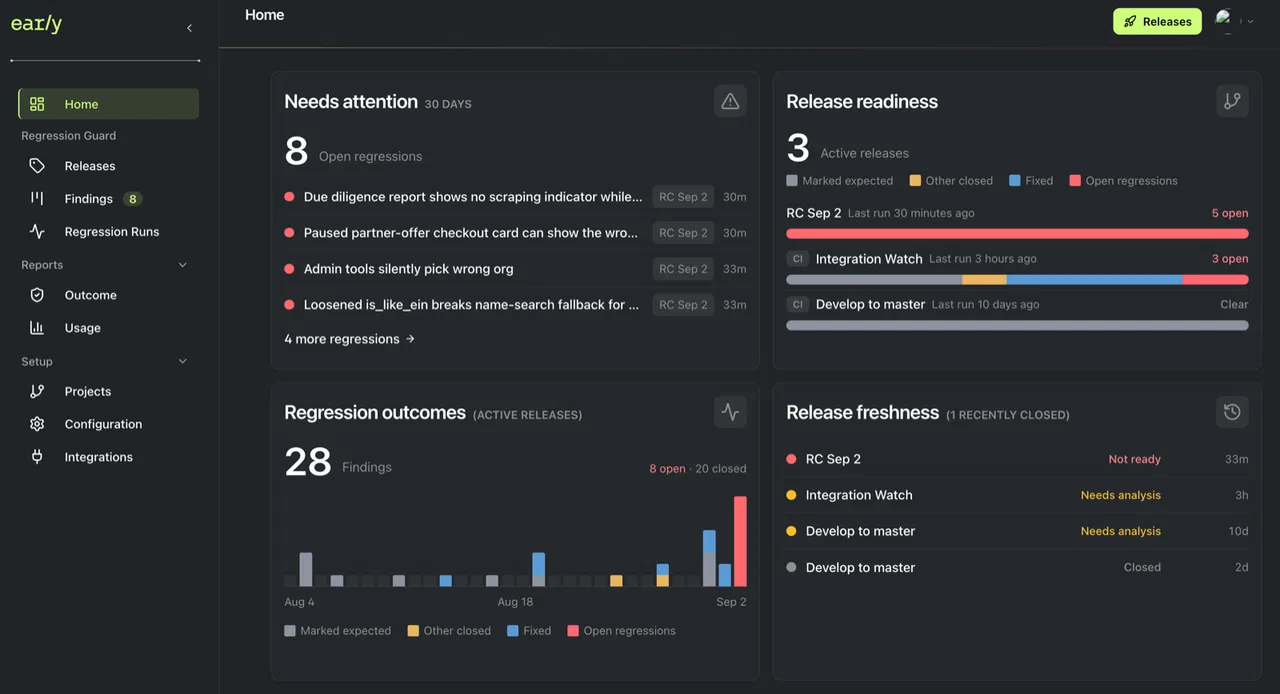
| 3 | EarlyAI | 4563 | +9,2 % | 39% direkt | Freemium, Kostenpflichtig | vs EarlyAI |
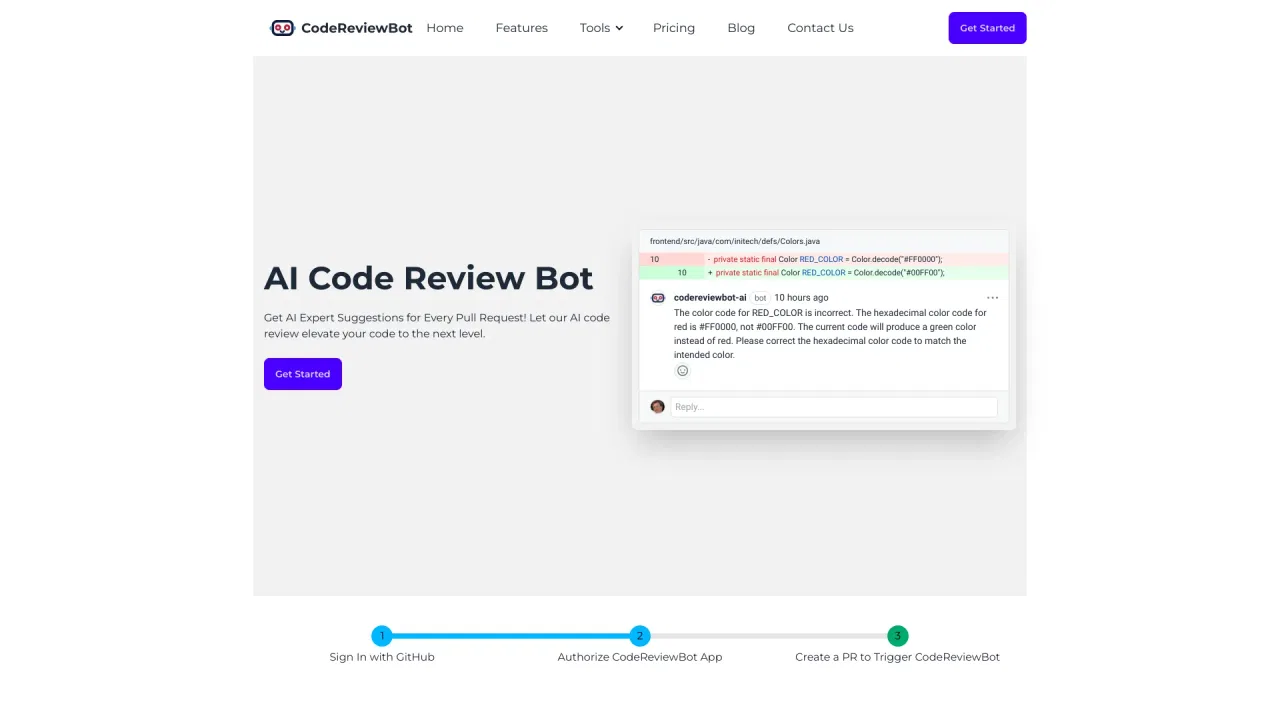
| 4 | CodeReviewBot.AI | 2515 | +97,1 % | 40% direkt | Freemium, Kostenlose Testversion, Kostenpflichtig, Preise auf Anfrage | vs CodeReviewBot.AI |
| 5 | CodeThreat | 674 | -70,5 % | 41% direkt | Freemium, Preise auf Anfrage | vs CodeThreat |
| 6 | Hacktron | 125.526 | -40,9 % | 28% direkt | Freemium, Kostenpflichtig, Preise auf Anfrage | vs Hacktron |
All-in-One-AppSec-Plattform, die Schwachstellen findet und automatisch behebt
All-in-One-AppSec-Plattform, die Schwachstellen findet und automatisch behebt

Der Coding-Agent, der deinen Coding-Stil lernt
Der Coding-Agent, der deinen Coding-Stil lernt
Bugs finden, Fix-PRs erhalten und vor jedem Release die Verifikationsnachweise sehen
Bugs finden, Fix-PRs erhalten und vor jedem Release die Verifikationsnachweise sehen

Automatisierte KI-Code-Reviews für jeden GitHub-Pull-Request
Automatisierte KI-Code-Reviews für jeden GitHub-Pull-Request
KI-natives SAST, das Pull Requests prüft und Fehlalarm-Rauschen reduziert
KI-natives SAST, das Pull Requests prüft und Fehlalarm-Rauschen reduziert

AI-native Offensive Security: kontinuierliches Red Teaming, Whitebox-Pentests und PR-Review

KI-Code-Review, die Ihre gesamte Codebasis versteht
KI-Code-Review, die Ihre gesamte Codebasis versteht

Agenten-Orchestrierung für den gesamten Softwareentwicklungszyklus
Agenten-Orchestrierung für den gesamten Softwareentwicklungszyklus

Das Sicherheitsgehirn, das KI-Coding-Agents an Ihre Regeln bindet
Das Sicherheitsgehirn, das KI-Coding-Agents an Ihre Regeln bindet

32 Sicherheitsscanner in einem KI-gefilterten DevSecOps-Durchlauf
32 Sicherheitsscanner in einem KI-gefilterten DevSecOps-Durchlauf

Eine Intelligenzschicht, die KI-generierten Code absichert
Eine Intelligenzschicht, die KI-generierten Code absichert

Agentisches KI-Pentesting für Web-Apps, APIs und GraphQL